
为了克服这些限制,整个行业正在经历一场范式转变。光收发器正朝着ASIC芯片的方向发展,旨在缩短电信号传输所需的铜通道长度。然而,尽管铜通道长度的缩短取得了进展,但偏离行业标准的可插拔架构所带来的挑战尚未完全解决。因此,行业可能正直接迈向更先进的解决方案,例如共封装光器件(CPO)。IDTechEx发布的报告《共封装光器件(CPO)2025-2035:技术、市场和预测》探讨了CPO技术的最新发展。该报告分析了关键的技术创新和封装趋势,评估了主要行业参与者,并提供了详细的市场预测,重点阐述了CPO的应用将如何改变未来数据中心的架构。.
共封装光学器件(CPO)的兴起
共封装光学器件 (CPO) 代表了数据传输技术的重大飞跃。CPO 将光引擎和开关硅集成在同一基板上。这种设计无需信号经过印刷电路板,进一步缩短了电通道路径,并显著提高了性能。.
缩短电通道路径至关重要,因为数据传输的核心依赖于基于铜的SerDes(串行器/解串器)电路,该电路将交换ASIC连接到可插拔收发器。随着数据需求的增长,SerDes技术不断发展以实现更快的传输速度,但更快的ASIC需要更好的铜连接,这可以通过增加通道数量或提高传输速率来实现。然而,随着链路密度和带宽的增加,系统功耗(以及成本)的很大一部分都消耗在将信号从ASIC驱动到机架边缘的光互连上。由于翘曲问题,ASIC BGA(球栅阵列)封装的尺寸限制要求更高的SerDes速率以支持更大的带宽。然而,这也会导致更高的功耗,因为更高的频率会产生更大的通道损耗。.
应对这些挑战的关键解决方案之一是缩短专用集成电路 (ASIC) 与光收发器之间的距离。系统的大部分功耗都消耗在将数据信号从 ASIC 传输到机架边缘的光互连上。将光收发器靠近 ASIC 可以带来以下几个优势:
降低信号损耗:缩短 ASIC 与光互连之间的电气路径可以最大限度地减少信号衰减。
降低功耗:缩短距离允许使用低功耗的串行器/解串器 (SerDes) 选项,从而降低系统整体功耗。
提高效率和性能:通过降低数据传输所需的功耗,可以显著提高系统效率和性能。可
扩展性:CPO 技术支持未来高带宽系统的扩展,使其成为需要满足不断增长的数据需求的数据中心的理想选择。
首席产品官将如何塑造人工智能的互联架构
首席产品官 (CPO) 蓄势待发,准备革新人工智能互连架构。在本文中,IDTechEx 以英伟达 (Nvidia) 的尖端 DGX NVL72 服务器为例,阐述了 IDTechEx 对下一代人工智能架构的构想。作为人工智能加速器市场的领导者,英伟达设计的 DGX NVL72 旨在重新定义人工智能性能标准,支持高达 27 万亿个参数,远超 ChatGPT 4 的 1.5 万亿个参数。.
DGX NVL72 包含 18 个计算节点,每个节点配备四个 Blackwell GPU 和两个 Grace CPU,以及九个 NVLink 交换机。像这样的现代 AI 加速器架构采用多个通信网络来管理数据流:
后端计算网络:在 DGX NVL72 架构中,每个计算节点通过 Nvidia 的 NVLink Spine 连接到 L1 计算交换机。NVLink Spine 是一种高速铜缆互连技术,可在 18 条 100G 通道上提供 1.8T 的双向带宽,每个连接使用 36 根铜线。L1 交换机也以类似的方式互连,整个系统总共使用 5,184 根铜线。为了在如此长的距离上保持信号完整性,交换机中使用了定时器,但这会引入延迟和带宽限制,尤其是在每条通道 100G 等较高速度下。此外,虽然铜缆链路成本效益高,但长距离传输时会受到信道损耗和时钟抖动等信号衰减问题的影响,并且随着带宽需求的增加,这些问题会变得更加明显。
光互连为铜互连提供了一种极具吸引力的替代方案,它能显著提高带宽密度,并在长距离传输中实现更高的效率——这对于涉及GPU间海量数据传输的AI工作负载至关重要。展望未来,铜互连有望被共封装光互连(CPO)所取代,从而实现计算节点之间的直接连接,并消除骨干网络中对L1计算交换机的需求。
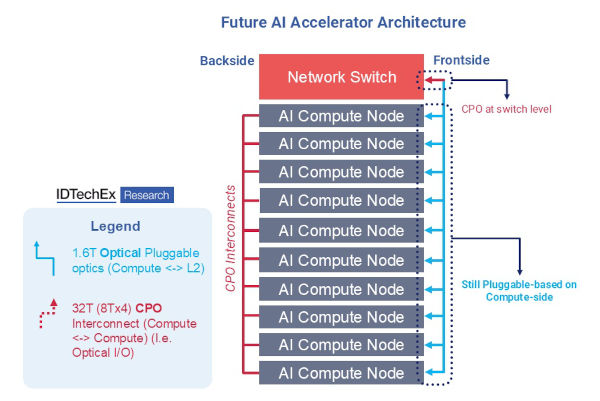
最终,CPO将重塑人工智能互连架构,改善数据流,减少瓶颈,并提升下一代人工智能系统的效率和可扩展性。未来我们很可能会看到直接光纤连接,从而省去计算交换机,提高人工智能工作负载的带宽,但这同时也会增加连接的复杂性。.
该报告的核心内容之一是将先进半导体封装技术视为共封装光学技术的基石。IDTechEx 特别强调理解不同半导体封装技术在共封装光学领域所能发挥的作用。.
作者:张宇涵博士,IDTechEx首席技术分析师