Pour surmonter ces limitations, l'industrie connaît une transformation profonde. Les émetteurs-récepteurs optiques se rapprochent des circuits intégrés spécifiques (ASIC), l'objectif étant de réduire la longueur du canal de cuivre nécessaire à la transmission du signal électrique. Cependant, malgré les progrès réalisés en matière de réduction de la longueur du canal de cuivre, les défis posés par l'abandon de l'architecture enfichable standard ne sont pas encore entièrement résolus. Par conséquent, l'industrie pourrait s'orienter directement vers des solutions plus avancées, telles que l'optique co-packagée (CPO). Le rapport d'IDTechEx, « Optique co-packagée (CPO) 2025-2035 : Technologies, marché et prévisions », explore les dernières évolutions de la technologie CPO. Il analyse les principales innovations techniques et les tendances en matière de packaging, évalue les principaux acteurs du secteur et fournit des prévisions de marché détaillées, soulignant comment l'adoption de la CPO transformera l'architecture future des centres de données.
L'essor des optiques co-emballées (CPO)
L'optique co-intégrée (CPO) représente une avancée majeure dans le domaine de la transmission de données. La CPO intègre le moteur optique et les circuits de commutation sur un même substrat. Cette conception élimine la nécessité pour les signaux de traverser le circuit imprimé, réduisant ainsi la longueur du trajet des canaux électriques et améliorant considérablement les performances.
La réduction de la longueur du trajet des canaux électriques est cruciale car le transfert de données repose essentiellement sur le circuit SerDes (sérialiseur/désérialiseur) à base de cuivre, qui relie le circuit intégré spécifique (ASIC) de commutation aux émetteurs-récepteurs enfichables. Face à la demande croissante de données, la technologie SerDes a évolué pour permettre une transmission plus rapide, mais des ASIC plus rapides exigent de meilleures connexions cuivre, soit par un plus grand nombre de canaux, soit par des débits plus élevés. Cependant, à mesure que la densité de liaisons et la bande passante augmentent, une part importante de la puissance du système – et donc de son coût – est consommée par le transport des signaux de l'ASIC vers les interconnexions optiques en périphérie du rack. Les limitations de taille des paquets BGA (Ball Grid Array) des ASIC, dues à des problèmes de déformation, imposent des débits SerDes plus élevés pour supporter une bande passante plus importante. Toutefois, cela entraîne également une consommation d'énergie plus élevée, car les fréquences plus élevées génèrent des pertes de canal plus importantes.
L'une des solutions clés à ces défis consiste à réduire la distance entre le circuit intégré spécifique (ASIC) et l'émetteur-récepteur optique. Une part importante de la puissance du système est consommée par la transmission des signaux de données de l'ASIC vers les interconnexions optiques en périphérie du rack. Rapprocher les émetteurs-récepteurs optiques de l'ASIC offre plusieurs avantages :
réduction des pertes de signal : raccourcir le trajet électrique entre l'ASIC et l'interconnexion optique minimise la dégradation du signal ;
consommation d'énergie réduite : la réduction de la distance permet l'utilisation d'options SerDes à faible consommation, ce qui diminue la consommation d'énergie globale du système ;
efficacité et performances accrues : en réduisant la puissance requise pour la transmission des données, l'efficacité et les performances du système sont considérablement améliorées ;
évolutivité : la technologie CPO favorise l'évolutivité future des systèmes à large bande passante, ce qui la rend idéale pour les centres de données devant répondre à des demandes de données croissantes.
Comment le CPO façonnera l'architecture d'interconnexion pour l'IA
Le CPO est sur le point de transformer l'architecture d'interconnexion pour l'IA. Dans cet article, IDTechEx utilise le serveur de pointe DGX NVL72 de Nvidia comme exemple pour expliquer sa vision de l'architecture d'IA de nouvelle génération. Nvidia, leader du marché des accélérateurs d'IA, a conçu le DGX NVL72 pour redéfinir les normes de performance de l'IA, en prenant en charge jusqu'à 27 000 milliards de paramètres, surpassant largement les 1 500 milliards de paramètres de ChatGPT-4.
Le DGX NVL72 comprend 18 nœuds de calcul, chacun équipé de quatre GPU Blackwell et de deux CPU Grace, ainsi que de neuf commutateurs NVLink. Les architectures d'accélérateurs d'IA modernes comme celle-ci utilisent plusieurs réseaux de communication pour gérer le flux de données :
Réseau de calcul dorsal : Dans l'architecture DGX NVL72, chaque nœud de calcul se connecte à un commutateur de calcul L1 via NVLink Spine de Nvidia, une interconnexion cuivre haut débit offrant une bande passante bidirectionnelle de 1,8 Tbit/s sur 18 voies de 100 Gbit/s, avec 36 fils de cuivre par connexion. Les commutateurs L1 sont interconnectés de la même manière, ce qui représente un total de 5 184 fils de cuivre pour l'ensemble du système. Afin de maintenir l'intégrité du signal sur ces distances, des temporisateurs sont utilisés dans les commutateurs. Cependant, ces derniers introduisent des limitations de latence et de bande passante, notamment à des débits élevés comme 100 Gbit/s par voie. De plus, bien que économiques, les liaisons cuivre souffrent de problèmes de dégradation du signal, tels que l'affaiblissement du canal et la gigue d'horloge, sur de longues distances. Ces problèmes s'accentuent avec l'augmentation des besoins en bande passante.
Les interconnexions optiques constituent une alternative intéressante au cuivre, offrant une densité de bande passante nettement supérieure et une efficacité accrue sur de longues distances – un atout essentiel pour les charges de travail d'IA impliquant des transferts massifs de données entre GPU. À l'avenir, les interconnexions en cuivre devraient être remplacées par des interconnexions optiques co-packagées (CPO), permettant des connexions directes entre les nœuds de calcul et éliminant ainsi le besoin de commutateurs de niveau 1 dans le réseau dorsal.
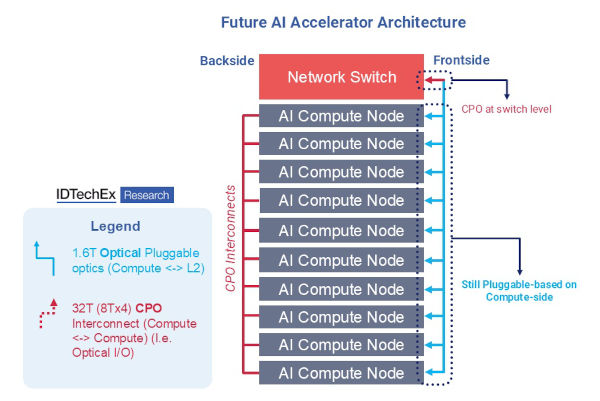
À terme, le CPO va remodeler l'architecture d'interconnexion de l'IA, améliorant le flux de données, réduisant les goulots d'étranglement et permettant une plus grande efficacité et une meilleure évolutivité des systèmes d'IA de nouvelle génération. Nous verrons probablement à l'avenir des connexions optiques directes, éliminant les commutateurs de calcul et augmentant la bande passante pour les charges de travail d'IA, même si cela augmentera également la complexité de ces connexions.
Un aspect central du rapport est la reconnaissance du conditionnement avancé des semi-conducteurs comme pierre angulaire de la technologie des optiques co-encapsulées. IDTechEx insiste particulièrement sur la compréhension du rôle que peuvent jouer les différentes technologies de conditionnement des semi-conducteurs dans le domaine des optiques co-encapsulées.
Auteur : Dr Yu-Han Chang, analyste technologique principal chez IDTechEx