



Quando un'organizzazione implementa un'applicazione web (ad esempio, su un server web Tomcat che interagisce tramite JDBC con un server di database SQL), invita chiunque a inviarle richieste HTTP/HTTPS. Gli attacchi nascosti in queste richieste possono aggirare le misure di sicurezza convenzionali come firewall, filtri, IPS, antivirus, ecc. Il codice di ogni applicazione web diventa parte del perimetro di sicurezza. Pertanto, il numero, le dimensioni e la complessità delle applicazioni web aumentano l'esposizione del perimetro di sicurezza di un'organizzazione. I siti web possono incorporare contenuti provenienti da molte fonti, come frame, script, CSS, oggetti (Flash), ecc. Il termine Web 2.0, emerso intorno al 2004, è associato ad applicazioni web che facilitano la condivisione interattiva delle informazioni, l'interoperabilità, la progettazione centrata sull'utente e la collaborazione web. I siti Web 2.0 stanno diventando sempre più interattivi, consentendo agli utenti di eseguire un maggior numero di operazioni in modi sempre più collaborativi. I mashup, ad esempio, consentono agli utenti web di integrare facilmente servizi di terze parti nei propri siti web. Uno degli elementi utilizzati nel Web 2.0 è la tecnica di programmazione chiamata AJAX (Asynchronous JavaScript and XML). Ad esempio, Google Maps utilizza AJAX nelle sue applicazioni web per l'elaborazione delle mappe. AJAX contribuisce a creare siti web e pagine web più accattivanti, ma offre anche agli hacker la possibilità di attaccare i server web e sfruttare un numero crescente di siti. I siti web basati su AJAX presentano una superficie di attacco più ampia perché interagiscono maggiormente con il browser e possono eseguire JavaScript lato client (PC, PDA, iPad, telefono cellulare, iPhone/Android, ecc.). AJAX ha aumentato la possibilità di rischi di Cross-Site Scripting (XSS), che si verificano quando lo sviluppatore del sito web non codifica correttamente le pagine. Un hacker può sfruttare queste vulnerabilità per rubare account utente, lanciare truffe di phishing per sottrarre informazioni e scaricare codice dannoso sui computer degli utenti.
 Attualmente, il rischio associato agli attacchi alle applicazioni è in costante aumento. Secondo il NIST, il 95% delle vulnerabilità si riscontra nel software. Secondo Gartner, il 75% degli attacchi avviene a livello applicativo. Secondo White Hat Security, sette siti web su dieci presentano gravi vulnerabilità. Secondo Forrester, il 62% delle organizzazioni ha subito una violazione della sicurezza negli ultimi dodici mesi. Secondo Cenzic, utilizzando i dati del NIST (con il suo NVD, NIST National Vulnerability Database), MITRE, SANS, US-CERT e OSVDB, si registra una tendenza crescente nelle vulnerabilità delle applicazioni web in percentuale sul totale: 73% nel secondo trimestre del 2008, 80% nel terzo trimestre del 2008 e 82% nel terzo e quarto trimestre del 2009. Secondo IBM, il numero di vulnerabilità delle applicazioni web è aumentato da un totale cumulativo di 2.000 nel 2004 a circa 15.000 nel 2008. Secondo Gartner, nel 2010 il 60% delle organizzazioni IT era già in grado di includere il rilevamento delle vulnerabilità come parte integrante dei propri processi del ciclo di vita dello sviluppo del software (SDLC). Secondo il "Website Security Statistics Report" del 2010 di Tom Brennan, la percentuale di siti web con almeno una vulnerabilità era la seguente: ASP (74%), ASPX (73%), Cold Fusion (86%), Struts (77%), JSP (80%), PHP (80%) e Perl (88%). Analogamente, la percentuale di siti web con almeno una vulnerabilità era la seguente: ASP (57%), ASPX (58%), Cold Fusion (54%), Struts (56%), JSP (59%), PHP (63%) e Perl (75%).
Secondo il CISO del Texas nel febbraio 2010, le tendenze degli attacchi per il 2010 erano: (i) Malware, worm e Trojan. Diffusi tramite e-mail, messaggistica istantanea e siti web infetti o dannosi. (ii) Botnet e zombie. Questi stanno migliorando le loro capacità di crittografia e occultamento e sono più difficili da rilevare. (iii) Scareware. Consiste in falsi software di sicurezza gratuiti infetti da malware. (iv) Attacchi al software lato client. Questi prendono di mira browser (Safari, Mozilla Firefox, Google Chrome, Opera, Netscape, Internet Explorer, Webkit, ecc.), lettori multimediali, lettori PDF, ecc. (v) Attacchi ransomware. Questi includono attacchi DDoS, malware che richiede denaro e, se l'utente rifiuta, crittografa il disco rigido, rendendolo inutilizzabile. (vi) Attacchi ai social media. La fiducia degli utenti negli amici online rende queste reti un obiettivo primario per gli aggressori, non solo per svago ma anche per scopi professionali. (vii) Cloud computing. Il suo crescente utilizzo lo rende un altro obiettivo prioritario per gli aggressori. (viii) Applicazioni Web. È noto che vengono sviluppate con controlli di sicurezza inadeguati. (ix) Tagli al budget. Questo è un grosso problema per il personale addetto alla sicurezza e una manna dal cielo per i criminali informatici.
Tipologie di componenti e struttura Web.
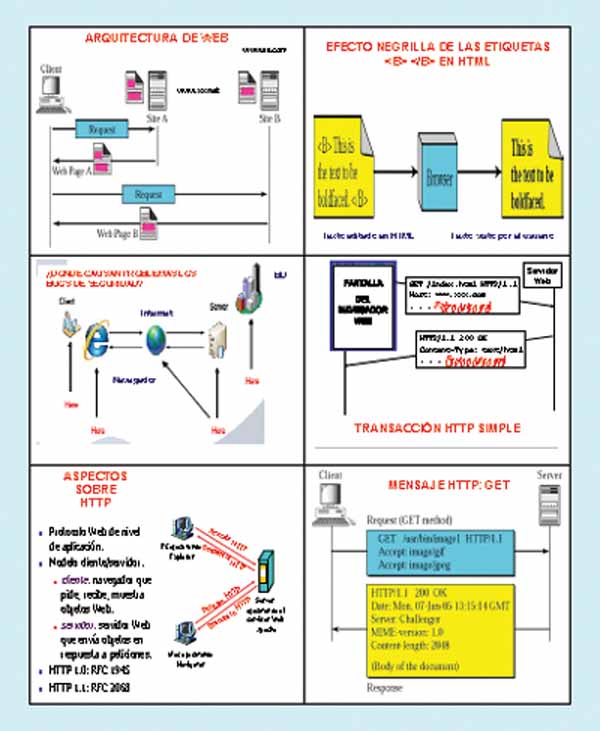
I principali componenti strutturali del Web sono: (i) Client/browser. (ii) Server. Questi vengono eseguiti su hardware sofisticato con processori multi-core. (iii) Cache. Queste consentono implementazioni interessanti e riducono i tempi di attesa. (iv) Internet. Questa è l'infrastruttura di rete globale che facilita il trasferimento dei dati sotto lo stack di protocolli TCP/IP. I principali componenti semantici del Web sono: (a) HTTP (Hypertext Transfer Protocol). HTTP è un protocollo di richiesta/risposta semplice, senza stato, che non crittografa i dati. È un protocollo a livello applicativo nello stack di protocolli TCP/IP tra un browser e un server e, quando integrato con SSL/TLS, forma HTTPS. Alcuni messaggi di richiesta HTTP sono: GET, il client richiede un documento al server utilizzando un URL; PUT, invia un documento dal server al client; HEAD, recupera informazioni sul documento specificato dall'URL, non il documento stesso; OPTIONS, recupera informazioni sulle opzioni disponibili; POST, il client invia informazioni al server, ad esempio, annotazioni; DELETE elimina un documento specificato da un URL; TRACE ripete la richiesta in entrata; CONNECT viene utilizzato dalle cache. Il primo tipo di messaggio HTTP è la richiesta. Il browser del client costruisce e invia messaggi come: una tipica richiesta HTTP è: GET http://www.labrs.com/index.html HTTP/1.0. Il secondo tipo di messaggio è la risposta. I server web costruiscono e inviano messaggi di risposta. Una tipica risposta HTTP è: HTTP/1.0 301 Moved Permanently Location http://www.rs.com/lab/index.html. Il browser web lato client comunica con uno o più server. Il browser effettua una richiesta e il server risponde con una risposta. Per mantenere lo stato tra le richieste, il server genera un token di sessione. Questo identificatore viene passato tra il browser e il server con ogni richiesta/risposta. Un cookie è un dato che può essere passato con la richiesta/risposta, ad esempio, come cookie di tracciamento per conoscere le preferenze di ciascun utente.
Le versioni HTTP sono: (i) HTTP 1.0 (RFC 1945). È un protocollo stop-and-wait. Utilizza una connessione TCP separata per ogni file. La connessione viene stabilita e rilasciata per ogni file. È caratterizzato da un utilizzo inefficiente dei pacchetti. Il server deve mantenere molte connessioni durante il tempo di attesa. I client effettuano richieste alla porta 80 dei server web, utilizzando il DNS per risolvere il nome del server in un indirizzo IP. I client stabiliscono una connessione TCP separata per ogni URL. Alcuni browser aprono più connessioni TCP (Netscape ne usa quattro per impostazione predefinita). Il server restituisce la pagina HTML. Esistono molti tipi di server con diverse implementazioni. Il server Apache è il più utilizzato ed è disponibile gratuitamente. Il browser interpreta la pagina e richiede gli oggetti incorporati. (ii) HTTP 1.1 (RFC 2068). Offre prestazioni migliorate, utilizza connessioni persistenti, pipelining, opzioni di caching e supporta la compressione. Le connessioni persistenti utilizzano la stessa connessione TCP per trasferire più file. Riduce significativamente il traffico di pacchetti e può o meno aumentare le prestazioni dal punto di vista del client se il carico del server aumenta. Il pipelining implica l'aggregazione di quanti più dati possibile in un singolo pacchetto. Richiede uno o più campi di lunghezza nell'intestazione HTTP. Può ridurre o meno il traffico di pacchetti o aumentare le prestazioni. In questo caso, la struttura della pagina è fondamentale. (b) Linguaggi come HTML (Hypertext Markup Language) e XML (Extensible Markup Language). HTML è un sottoinsieme di SGML (Standardized General Markup Language) e facilita un ambiente con collegamenti incorporati ad altri documenti e applicazioni. I documenti HTML utilizzano elementi per identificare sezioni di testo con scopi diversi o per visualizzare caratteristiche, come il testo in grassetto. Gli elementi di markup non sono visibili all'utente durante la visualizzazione della pagina. I documenti vengono visualizzati dai browser. Non tutti i documenti web sono HTML e gli sviluppatori utilizzano editor WYSIWYG per generare HTML. (c) Meccanismi di denominazione che utilizzano URI (Uniform Resource Identifier).
Le risorse web necessitano di nomi/identificatori, ovvero URI. La risorsa può risiedere ovunque su Internet. Gli URI sono un concetto astratto: un puntatore a una risorsa a cui è possibile applicare metodi di richiesta per generare risposte potenzialmente diverse; l'URI si collega ad applicazioni generiche (http, ftp, telnet, ecc.). Un metodo di richiesta consiste, ad esempio, nella ricerca o nella modifica dell'oggetto. L'esempio di URL: http://www.abc.com/index.html include il protocollo (http://, ftp://, telnet://, mailto://)
 Sistema di modellazione delle minacce STRIDE/DREAD per applicazioni Web.
Il sistema di modellazione delle minacce STRIDE/DREAD si basa su: (1) STRIDE, che identifica le seguenti categorie di minacce: (i) Spoofing dell'identità. Lo spoofing dell'identità è un rischio chiave nelle applicazioni che hanno molti utenti ma utilizzano un singolo contesto di esecuzione a livello di applicazione e di database. Gli utenti non dovrebbero essere in grado di impersonare un altro utente o diventare quell'utente. (ii) Manomissione dei dati. Gli utenti possono modificare qualsiasi dato loro fornito e possono quindi modificare la convalida lato client, i dati GET e POST, i cookie, le intestazioni HTTP, ecc. L'applicazione non dovrebbe inviare dati all'utente, come tassi di interesse o periodi, che sono ottenibili all'interno dell'applicazione stessa.
L'applicazione deve controllare attentamente tutti i dati ricevuti dall'utente per determinare se sono accurati e applicabili. (iii) Ripudio. Gli utenti possono contestare le transazioni se non vi è sufficiente tracciabilità e verifica dell'attività dell'utente. Ad esempio, se un utente afferma: "Non trasferirò denaro a questo conto esterno", e le sue attività non possono essere tracciate dall'inizio alla fine dell'applicazione, la transazione dovrà molto probabilmente essere annullata. Le applicazioni dovrebbero disporre di controlli di ripudio adeguati, come i log di accesso web, i log di audit a ogni livello e il contesto utente dall'alto verso il basso. Idealmente, l'applicazione dovrebbe essere eseguita come l'utente, ma questo spesso non è possibile con molti framework. (iv) Divulgazione delle informazioni. Gli utenti sono restii a divulgare dettagli privati a un sistema. Se è possibile per un malintenzionato divulgare i dettagli dell'utente, in modo anonimo o come utente autorizzato, si verificherà una perdita di ripudio. Le applicazioni devono includere controlli rigorosi per impedire la manomissione dell'identità dell'utente, in particolare quando si utilizza un singolo account per eseguire l'intera applicazione. Il browser dell'utente può divulgare informazioni. Non tutti i browser implementano correttamente le politiche di non memorizzazione nella cache richieste dalle intestazioni HTTP. Ogni applicazione ha la responsabilità di ridurre al minimo la quantità di informazioni memorizzate da un browser, nel caso in cui le informazioni vengano divulgate e un utente malintenzionato possa utilizzarle per saperne di più sull'utente o addirittura impersonarlo. (v) Negazione del servizio. Le applicazioni devono essere consapevoli di poter essere bersaglio di un attacco denial-of-service. Per le applicazioni autenticate, le risorse costose come file di grandi dimensioni, calcoli complessi, ricerche robuste o query lunghe dovrebbero essere riservate agli utenti autorizzati, non agli utenti anonimi. Per le applicazioni che non hanno questo lusso, ogni aspetto dell'applicazione dovrebbe essere implementato per eseguire il minor lavoro possibile, utilizzare query di database veloci (o meno) ed evitare di esporre file di grandi dimensioni o fornire link univoci per utente per prevenire un semplice attacco denial-of-service. (vi) Elevazione dei privilegi. Se un'applicazione fornisce ruoli utente e amministratore, è fondamentale garantire che l'utente non possa elevarsi a ruoli con privilegi superiori. In particolare, non fornire link utente non è sufficiente; Tutte le azioni devono essere controllate da una matrice di autorizzazione per garantire che solo i ruoli corretti possano accedere alle funzionalità privilegiate. (2) DREAD. Questo viene utilizzato per calcolare il valore di rischio, che è la media aritmetica di cinque elementi: Rischio (DREAD) = (Danno + Riproducibilità + Sfruttabilità + Utenti interessati + Individuabilità) / 5. Consiste in: (i) Potenziale di danno. Questo misura l'entità del danno causato se una minaccia viene attuata. Un valore di zero significa nessuno, un valore di cinque significa che i dati di un singolo utente sono stati interessati o compromessi e un valore di dieci significa i dati dell'intero sistema. (ii) Riproducibilità. Questo misura quanto facilmente questa minaccia può essere riprodotta. Un valore di zero significa molto difficile o impossibile, anche per gli amministratori dell'applicazione. Un valore di cinque significa che se sono necessarie una o due fasi, potrebbe essere necessario un utente autorizzato. Un valore di dieci significa solo la barra degli indirizzi del browser senza essere autenticati. (iii) Sfruttabilità. Misura ciò che è necessario per sfruttare questa minaccia. Un valore pari a zero significa disporre di strumenti di attacco avanzati e personalizzati, competenze di rete e programmazione avanzata; un valore pari a cinque significa che esiste un malware o che viene eseguito utilizzando strumenti di attacco standard; e un valore pari a dieci significa disporre solo di un browser. (iv) Utenti interessati. Misura quanti utenti saranno interessati da questa minaccia. Un valore pari a zero significa nessuno; un valore pari a cinque significa alcuni utenti ma non tutti; e un valore pari a dieci significa tutti gli utenti. (v) Rilevabilità. Misura quanto è facile scoprire questa minaccia. Un valore pari a zero significa molto difficile o impossibile; richiede l'accesso al sistema o alla sorgente; un valore pari a cinque significa che può essere rilevata esaminando le tracce di rete; un valore pari a nove significa che i dettagli di vulnerabilità come questa sono disponibili pubblicamente e possono essere scoperti utilizzando motori di ricerca ad alte prestazioni come Google, Yahoo, ecc.; e un valore pari a dieci significa che si trova nella barra degli indirizzi o in un modulo.
Vulnerabilità Web comuni. Misure di sicurezza proattive.
Diverse fonti ci consentono di identificare vulnerabilità, minacce e rischi per la sicurezza del web: (i) OWASP (Open Web Application Security Project) pubblica un documento annuale intitolato "Top 10 Mitigable Threats/Risks", basato sui dati grezzi del MITRE CVE. (ii) SANS pubblica un documento annuale intitolato "SANS Top 20 Internet Security Attack Targets". (iii) eEye Digital Security. (iv) Zero-Day Tracker. (v) US-CERT aggiorna le sue informazioni settimanalmente. Una vulnerabilità nei browser web come IE, Safari, ecc., è la loro capacità di intraprendere automaticamente azioni per limitare l'impatto delle incongruenze delle pagine web. Ad esempio, se una pagina web perde il tag di chiusura `</body>`, il browser potrebbe visualizzare la pagina correttamente o eseguire JavaScript anche se la parola è divisa su due righe all'interno di un tag `<script>`, una riga che indica `java` e l'altra che specifica `script`. Gli aggressori sfruttano questa vulnerabilità per causare il malfunzionamento di un sito web. Esistono diffuse idee errate sulla sicurezza delle applicazioni web, come ad esempio la convinzione che SSL/TLS protegga un sito web, che i firewall convenzionali proteggano le applicazioni web o che IDS/IPS proteggano i server web e di database. La sicurezza delle applicazioni web non può essere affrontata unicamente con software antivirus, scanner di vulnerabilità, firewall/DMZ, IDS/IPS, gestione delle patch/conformità e sicurezza dei server. Richiede anche ulteriori misure di sicurezza come l'analisi statica (alcuni fornitori di strumenti di analisi statica includono Veracode, Fortify, Coverity, KlocWork e OunceLabs) e l'analisi dinamica (alcuni fornitori di strumenti di analisi dinamica includono IBM con RationalAppscan, HP con WebInspect, Ntoobjectives con NTOSpider, Cenzic con Hailstorm e Whitehat Security), firewall per applicazioni web/XML, revisione e analisi del codice, protezione completa del ciclo di vita dello sviluppo del software (SDLC) e formazione degli sviluppatori.
Gli approcci reattivi alle violazioni della sicurezza sono insufficienti e portano a un ciclo infinito di crisi che spesso culminano in un disastro totale. Pertanto, sono ora essenziali misure di protezione proattive, quali: (i) Test di sicurezza integrati durante l'intero ciclo di vita dello sviluppo del software (SDLC). (ii) Ritest e ricertificazione in caso di modifiche significative al sistema o all'ambiente dell'applicazione web. (iii) Revisione dell'architettura e analisi delle potenziali vulnerabilità (gap). (iv) Implementazione di sicurezza integrata e difesa multilivello. (v) Utilizzo di firewall XML per i servizi web, in grado di mitigare minacce quali SQL injection, attacchi a entità esterne, payload ricorsivi, avvelenamento dello schema, attacchi denial-of-service, buffer overflow, ecc., tramite verifica WSDL, convalida dello schema XML, routing basato sul contenuto XML, ecc.
Considerazioni finali
Il nostro gruppo di ricerca lavora da oltre vent'anni nel campo della sintesi e dell'analisi della sicurezza nel contesto delle applicazioni web.
Questo articolo fa parte delle attività svolte nell'ambito del progetto LEFIS-APTICE (finanziato da Socrates, Commissione europea).
Autore: Prof. Dr. Javier Areitio Bertolín – E.Mail:
Bibliografia
- Areitio, J. “Sicurezza delle informazioni: reti, informatica e sistemi informativi”. Cengage Learning-Paraninfo. 2010.
- Areitio, J. “Nuovi approcci nell’analisi dei sistemi per il rilevamento, la prevenzione e la gestione di attacchi e intrusioni”. Rivista Conectrónica. N. 123. Gennaio 2009.
- Fry, C. e Nystrom, M. “Monitoraggio della sicurezza. Metodi comprovati per il rilevamento degli incidenti su Enterprise 200.







